← Журнал · · Разбор
Inference serving platform: в начале было Слово
Начнем серию постов про инференс платформы. Знаю, вы ждали это!
А начнем мы с пролога - поэтому «В начале было Слово»
Что такое инференс?
Обратимся к кембриджскому словарю и определим значение слова Inference.
a *guess* that you make or an opinion that you form based on the *information that you have*
------------
*предположение*, которое вы делаете, или мнение, которое вы формируете на основе *имеющейся у вас информации*
Предсказание модели — это предположение, основанное на входных данных и той информации, которая она уже имеет (веса модели).
результат = model.predict(data)
То есть с точки зрения определения - Инференс это результат работы операции predict на основе переданных данных.
Инференс-сервис - это API эндпоинт до метода model.predict(data).
А где держать бизнес-логику? - В этой статье Nvidia как раз разбирают кейсы миграции с монолита в отдельный инференс-сервис.
Зачем отделять бизнес-логику?
Здесь важно понять отличие от веб-сервиса с бизнес-логикой. У нас появляется новая сущность - модель. Некий черный ящик со своим жизненным циклом. Отделение модели в отдельную сущность позволяет решить проблему масштабирования, особенно когда требуются такие дорогие ресурсы как GPU.
Пре/пост-процессинг может жить рядом с инференсом, чтобы уменьшить latency. Но нужен механизм удобного масштабирования реплик каждой сущности отдельно (ведь для них может и не нужен GPU, когда для модели - нужен). Использовать пре/пост-процессинг для реализации бизнес-логики не порождает отдельный сервис, но накладывает ограничения на поддержку и масштабирование.
Чтобы избавиться от головной боли оркетрирования и масштабирования ресурсов используются Inference serving platform.
Движок, сервис, платформа - в чем разница?
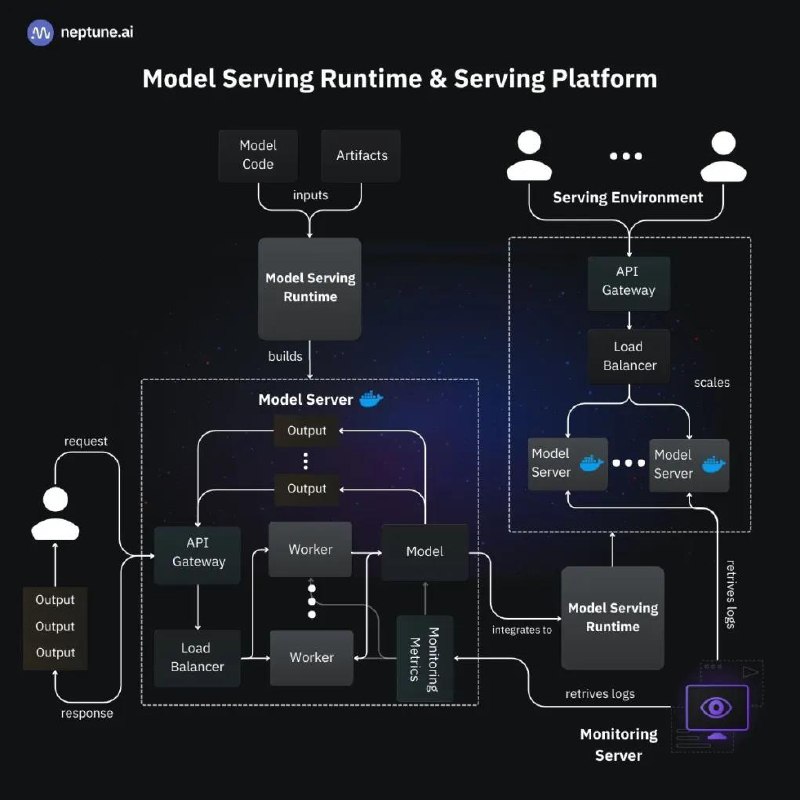
Инференс-сервис - конечный enpoint до модели с автоскейлингом, сервис мешем и полным фаршем. Пользователь взаимодействует именно с ним. Связка движка и платформы.
Инференс-движок (рантайм) - сервер-обертка нашей модели. Выдает endpoint к вашей модели (onnx, torch, llm). Например - vllm, triton, ml-server, onnx-runtime
Инференс-платформа - оркестратор ваших инференсов. Включает service-mesh, скейлинг ресурсов, оркестрирование создаваемых инференсов. Примеры таких платформ я категоризую на две группы:
K8S-oriented платформы - предоставляют CRD для создания инференсов из манифестов. Оркестрируют на уровне куба.
- Kserve
- Seldon
Dev-oriented платформы - некие кубернетесы внутри кубернетеса. Для создания инференсов создается "inference" cluster, по сути повторяющий работ k8s. Но интерфейс больше ориентирован на разработчиков.
- Yatai (BentoML)
- KubeRay (Ray Serve)
Также рекомендую посмотреть эту статью - как обзор инференс-платформ. Пока не теряет актуальности.
В следующих постах хотел бы подробнее поговорить о каждой платформе. А сейчас прошу вас проголосовать в опросе, интересно кто что использует у себя.