← Журнал · · Разбор
Почему ML-образы так долго деплоятся
Всем привет!
Давно не было постов и сейчас хотел бы поделиться с вами одним из своих исследований)
Столкнулся со следующей проблемой - в мире ML докер образы делают с жирком, все библиотеки весят много, плюс CUDA 5-6гигов минимум. Итого получается овер 10-15 гигов одного только образа😱 Представьте - вы делаете автомасштабируемую систему, например, в том же кубернетесе. При автоскейлинге поднимается новая нода (она голая, образов, которые вы используете там нет). В итоге в одном из моих кейсов деплой новой реплики занимал порядка 10 минут (2 минуты поднимается нода, 8 минут пуллится и сетапится образ контейнера). Достаточно долго, особенно если вам хотелось бы иметь систему без задержек (чтобы не терять трафик клиентов)
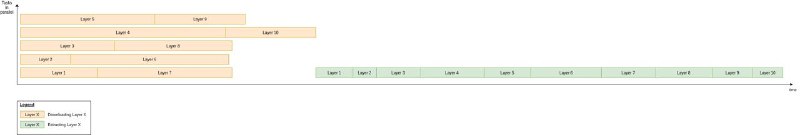
Я начал исследовать в сторону кеширование образов (где нибудь рядом с нодами), здесь можно посмотреть различные решения (но на medium возможно придется заходить через впн). Развернул кеширующий реджестри в кластере, но выиграл только в скорости скачивание слоев (они скачиваются параллельно, из 8 минут удалось сократить до 6). Проблема же оказалась в экстрактинге (он однопоточный, если слой 5+гигов то разархивируется достаточно долго). На графике как раз видно, как происходит пуллинг слоев и их экстрактинг